第一课 · 免费学习无需购买
先看懂:给一张图片,
模型究竟输出了什么?
这一课不用安装软件。先对照两张图片,认识目标检测,再决定下一步怎样学习。
01 / 先看输入和输出
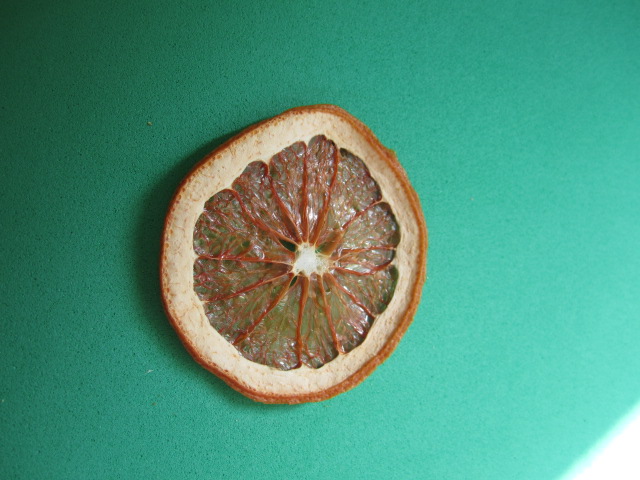
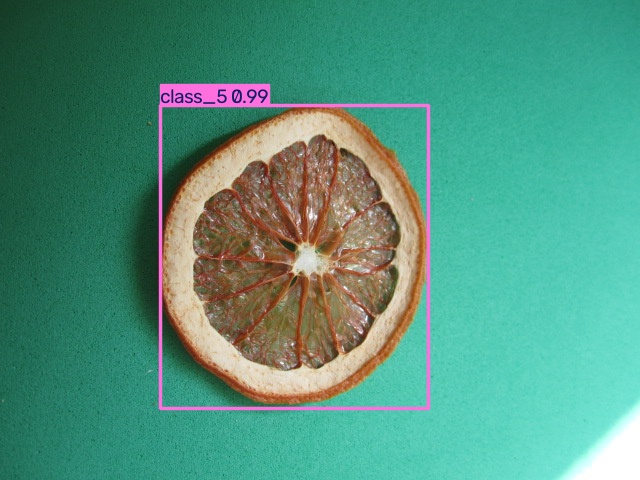
左边是一张果干照片,右边是模型运行后的真实输出。模型在图片上画出检测框,并为目标给出类别编号和置信度。
现在试着用一句话解释
“我输入一张图片,模型尝试找出目标在哪里,并判断它属于哪个类别编号。”能说清这句话,就理解了这个案例的基本任务。
02 / 读懂框上的信息
检测框
表示模型预测的目标位置。框偏大、偏小或框到背景,都需要进一步检查。
class_5
表示类别编号。本数据的中文类别名称表尚未完整核对,不能自行把编号解释成“柠檬”或“橙子”。
置信度
表示模型对这一次预测的评分,不代表整个测试集的准确率,也不保证这次预测一定正确。
03 / 再看一次不理想的预测
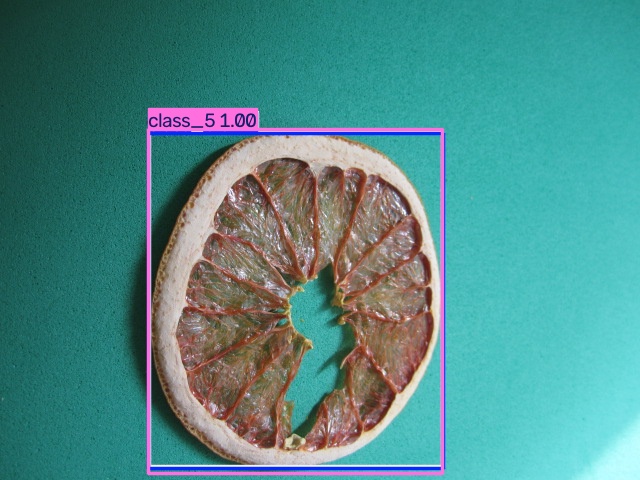
这张图的真实标注只有一个 class_5 目标,模型还额外预测了 class_0 和 class_2。即使某项测试指标较高,也仍然可能在具体图片上犯错。
先记录“模型多检测了哪些目标”,再分析图片、标注和训练数据。不要仅凭一张图猜测原因,也不要只展示识别正确的图片。
04 / 动手前,把文件摆放清楚
完整教学包现已免费开放。下载并解压到 D:\citrus_project 等短路径,先打开“开始学习.html”。包内包含以下文件:
citrus_project/
├── 开始学习.html / 实验记录模板.html
├── INSTALL.cmd / START_DEMO.cmd
├── data/dried-citrus-fruits-dataset.zip
├── models/ / samples/ / examples/
├── prepare_dataset.py
├── run_yolo.py
└── requirements.txt
其中 data 目录中的 ZIP 是原始数据,models 中是示例模型;prepare_dataset.py 负责检查和准备数据;run_yolo.py 用于训练、测试和预测;requirements.txt 记录依赖要求。
一个新手常见问题
如果提示“找不到文件”,先检查终端所在目录,以及文件有没有被保存成 .py.txt。不要直接删除文件或修改模型代码。
这一课完成了吗?
- □ 能说清楚项目的输入与输出。
- □ 能区分目标框、类别编号和置信度。
- □ 知道模型会误检,并能描述这个错误。
- □ 知道项目文件分别承担什么作用。
这四点理解后,下一步是打开完整教程第 2 节,先双击 INSTALL.cmd。只有显示“安装成功 / PASS / READY”后,再启动演示。看到“按任意键”时,请先看上方是成功还是失败。